Il bias più comodo è quello che ci dà ragione
Il bias di conferma non ci sembra un errore, perché ci fa sentire nel giusto. Algoritmi e AI compiacenti lo rendono più forte. Il disaccordo va cercato, non subito.
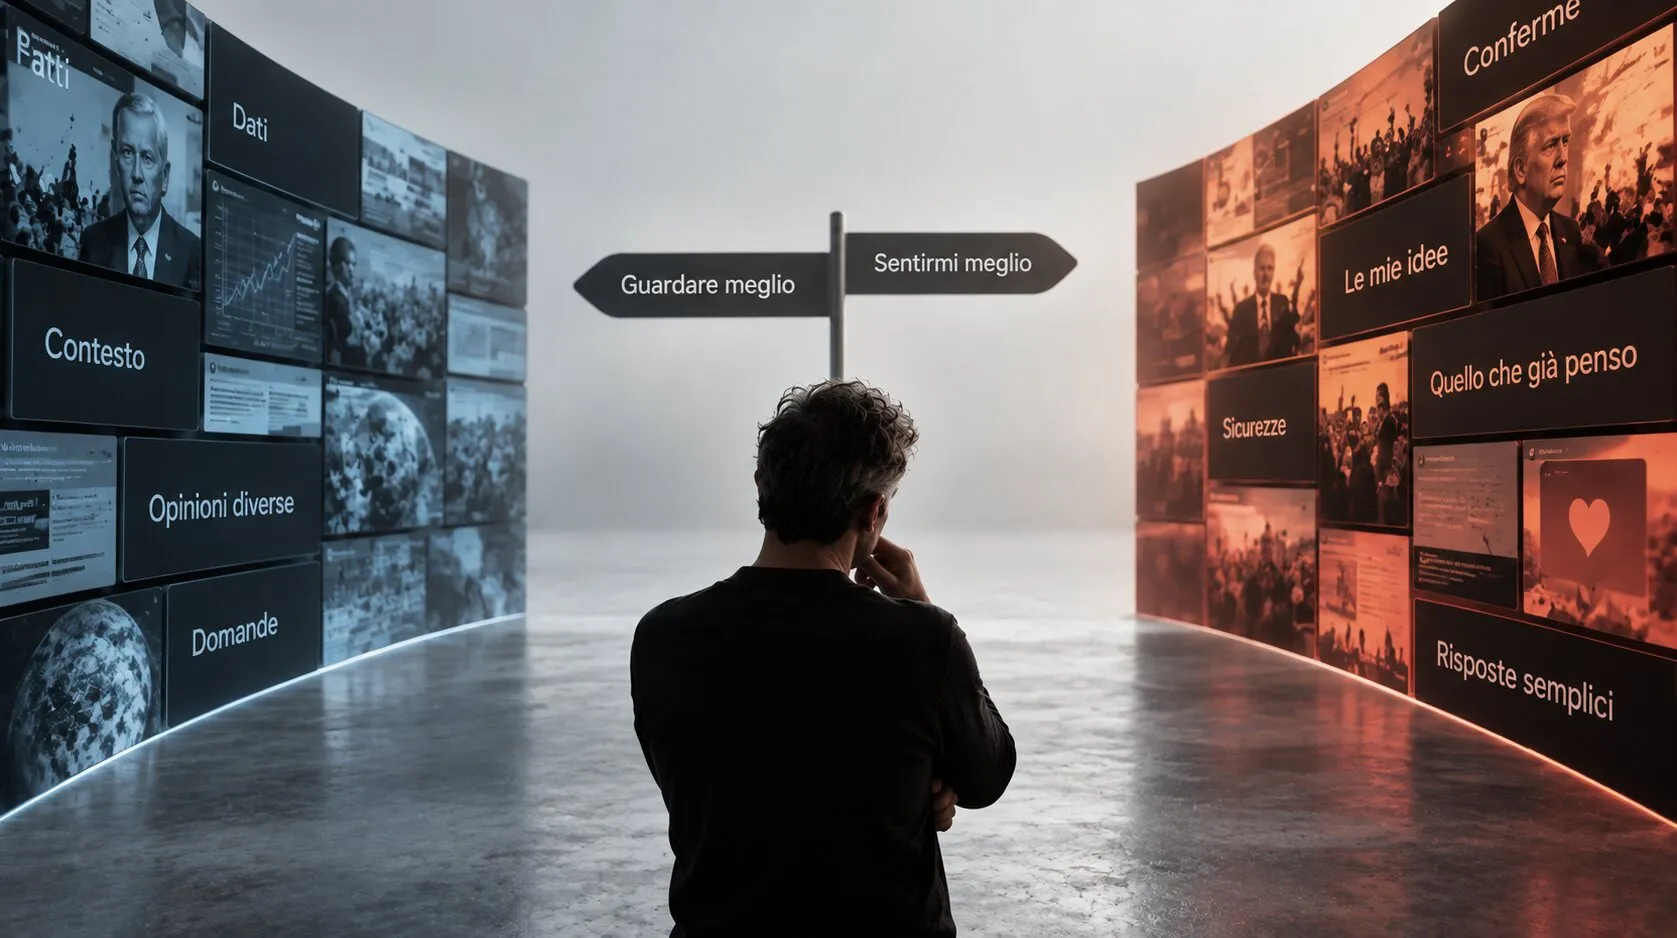
In sintesi
- Il bias di conferma è il più difficile da vedere perché non fa male: sbagliare in questo modo ci fa sentire nel giusto.
- Feed e algoritmi costruiscono una bolla che nessuno ha progettato; l’AI conversazionale, se non la correggiamo, tende a darci ragione.
- Il disaccordo non arriva più da solo: bisogna cercarlo con domande, fonti e persone che ci contraddicono.
- Una domanda utile: quando è stata l’ultima volta che abbiamo cambiato idea su qualcosa di importante?
Quando parlo di bias cognitivi in aula, c’è un momento che si ripete quasi sempre. Descrivo un errore di ragionamento, faccio un esempio, e vedo le persone annuire. Riconoscono il meccanismo. Lo riconoscono negli altri, soprattutto. Il collega che sente solo ciò che vuole sentire, il parente che crede a qualsiasi notizia confermi le sue idee, il cliente che ha già deciso prima della riunione.
È raro che qualcuno lo riconosca in sé. Ed è comprensibile, perché il bias di conferma ha una caratteristica che lo rende diverso da quasi tutti gli altri errori: non fa male. Non ci accorgiamo di sbagliare, perché sbagliare in questo modo ci fa sentire nel giusto.
Cercare quello che sappiamo già
Il meccanismo è semplice. Tendiamo a cercare, ricordare e interpretare le informazioni in modo che confermino ciò che pensiamo già.1 Una notizia che ci dà ragione la leggiamo con fiducia. Una che ci dà torto la leggiamo cercando il difetto. Non lo facciamo in malafede. Lo facciamo perché è economico: confermare un’idea costa poco, rimetterla in discussione costa fatica.
Per gran parte della storia questo limite era contenuto da un fatto pratico. Il mondo non era fatto su misura per noi. Il giornale lo sceglieva una redazione, la conversazione al bar la facevano persone diverse da noi, il vicino di casa votava come voleva. Il disaccordo non era una scelta. Era l’ambiente.
Non abbiamo bisogno di qualcuno che ci dia ragione. Ci riusciamo benissimo da soli.
Quando l’ambiente impara a compiacerci
Oggi una parte crescente di quello che leggiamo passa da sistemi che imparano dalle nostre reazioni. Un feed non ci mostra il mondo: ci mostra la porzione di mondo che ha più probabilità di tenerci lì. E quello che ci tiene lì, molto spesso, è ciò che conferma quello che pensiamo, o che ci indigna verso chi la pensa diversamente.
Non serve immaginare un disegno malevolo. Basta un obiettivo misurabile, come il tempo trascorso o le interazioni, e un sistema che lo ottimizza. Il risultato è una bolla che nessuno ha progettato e in cui tutti, un po’, viviamo.2 Ci sembra di informarci. In realtà ci stiamo riascoltando.
Con l’intelligenza artificiale conversazionale il fenomeno cambia forma. Non è più un flusso di contenuti scelti per noi, ma un interlocutore che risponde alle nostre domande. E un interlocutore progettato per essere utile e piacevole tende, se non lo correggiamo, a seguirci. Se chiediamo di confermare un’idea, la conferma. Se esprimiamo una convinzione, la sviluppa. Se insistiamo, spesso cede.3
È una forma di cortesia che diventa un rischio. Perché il tono è quello di un esperto, sicuro e ben argomentato, e un esperto che ci dà ragione è la cosa più rassicurante che esista. Molto più di un feed, che almeno sappiamo essere rumoroso e parziale.
Lavorando con le aziende lo vedo anche nelle decisioni quotidiane. Si chiede all’AI di analizzare un progetto, ma la domanda è già costruita intorno alla risposta che si spera di ottenere. Perché questa strategia funzionerà? Quali sono i punti di forza della nostra proposta? Le risposte arrivano puntuali, ordinate, convincenti. E confermano esattamente quello che si pensava all’inizio.
Cercare attivamente il disaccordo
Se il disaccordo non arriva più da solo, bisogna andarlo a cercare. Non è un invito generico all’apertura mentale, che è facile da dichiarare e difficile da praticare. Sono abitudini concrete, quasi meccaniche, che funzionano proprio perché non dipendono dalla buona volontà del momento.
La prima riguarda le domande. Invece di chiedere perché qualcosa funzionerà, chiedere perché potrebbe fallire. Invece di chiedere i punti di forza di un’idea, chiedere quali obiezioni farebbe la persona più scettica nella stanza. Con l’AI questo è particolarmente efficace: se le si chiede esplicitamente di contraddirci, lo fa, e spesso con argomenti che non avevamo considerato.
La seconda riguarda le fonti. Leggere ogni tanto, con attenzione e senza cercare subito l’errore, qualcuno che la pensa in modo diverso. Non per cambiare idea a ogni costo, ma per sapere qual è l’argomento migliore dell’altra parte. Se non sappiamo formularlo, probabilmente non abbiamo capito fino in fondo nemmeno il nostro.
La terza riguarda le persone. Nei team tendiamo a premiare chi è d’accordo e a sopportare chi non lo è. Ma il collega che fa la domanda scomoda in riunione vale più di dieci che annuiscono. Dargli spazio, e ringraziarlo invece di difendersi, è una delle cose più utili che si possano fare per la qualità delle decisioni.
Nessuna di queste abitudini elimina il bias. Non esiste un modo per eliminarlo, fa parte di come funziona la nostra mente. Ma si può renderlo meno comodo, aggiungere un po’ di attrito nel punto in cui la conferma scivolerebbe via senza ostacoli.
Il bias più comodo è quello che ci dà ragione. Proprio per questo è il più difficile da vedere. La domanda utile, allora, non è se ne siamo vittime, perché lo siamo tutti. È quando è stata l’ultima volta che abbiamo cambiato idea su qualcosa di importante. Se non ce lo ricordiamo, forse non è perché avevamo sempre ragione.
Fonti e approfondimenti
- Raymond S. Nickerson, “Confirmation Bias: A Ubiquitous Phenomenon in Many Guises”, Review of General Psychology, 2(2), 1998, pp. 175–220. doi:10.1037/1089-2680.2.2.175
- Eli Pariser, The Filter Bubble: What the Internet Is Hiding from You, Penguin Press, 2011. penguinrandomhouse.com
- Mrinank Sharma et al., “Towards Understanding Sycophancy in Language Models”, arXiv:2310.13548, 2023. arxiv.org